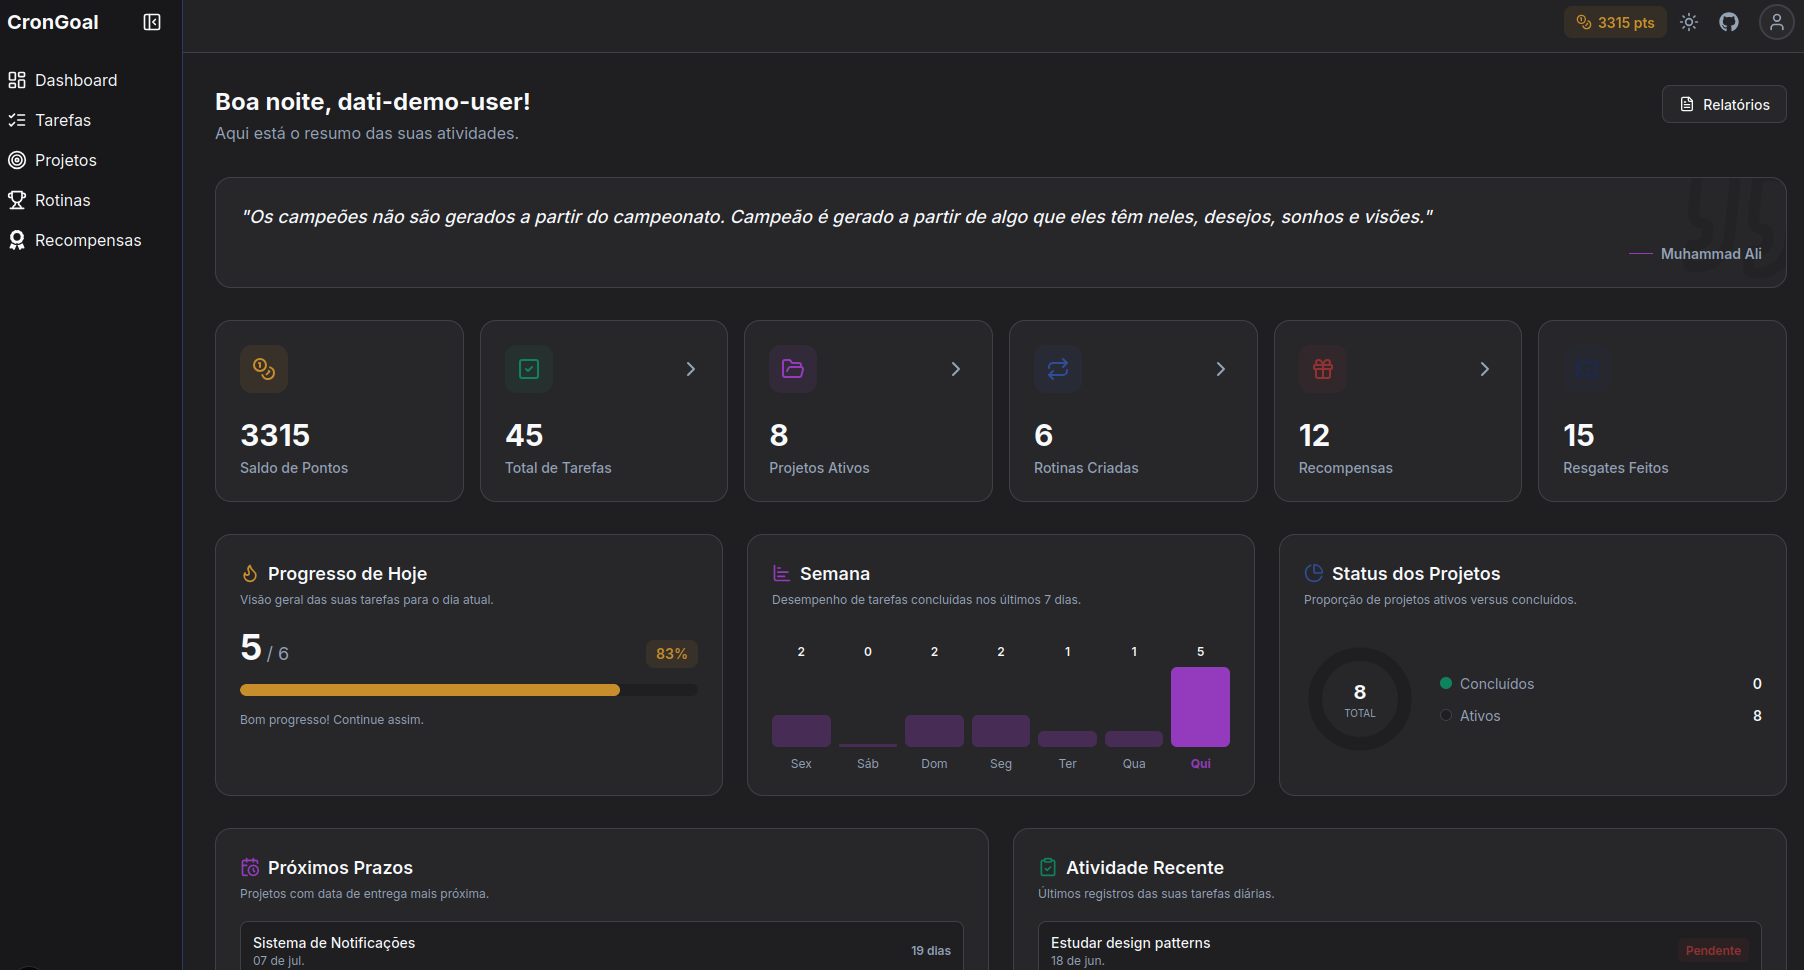
Uma API de produtividade com autenticação, autorização e backend TypeScript organizado em camadas.
TypeScript
Node.js
Express
PostgreSQL
Prisma
JWT/OAuth2
NASA Space Apps Challenge · 2025Campeão local · Global Nominee
Identidade conceitual do projeto
01.Earthdata → 02.AirMood → 03.Pessoas
AirMood
Observação da Terra, mais perto das pessoas.
Um assistente com interface de voz que conecta qualidade do ar, clima e dados de satélite a decisões do dia a dia.
Python
Streamlit
NASA Earthdata
Geospatial
EY AI & Data Challenge · 2026Projeto de dados e machine learning
Fluxo conceitual
01.Landsat + clima → 02.Atributos → 03.Modelo
WaterScript
Uma visão mais ampla da qualidade da água.
Pipeline multimodal que combina amostras de água, imagens Landsat e dados climáticos para modelar qualidade da água.
Python
Snowflake
XGBoost
Geospatial
Construído na prática.
De processos industriais a software e dados, aprendendo ao resolver problemas reais.
Tramontina Multi S.A.
Cargo atual
Desenvolvedor · Backend e Engenharia de Dados
Pipelines de dados em produção, integrações backend e ferramentas para o ecossistema Databricks.
Tecnologias
Python
PySpark
SQL
Databricks
Delta Lake
Unity Catalog
Flask
Docker
Pipelines de dados
Construção e manutenção de mais de 20 jobs batch com PySpark, SQL, Delta Lake e Unity Catalog. Migração de um pipeline de aproximadamente 20 notebooks para Lakeflow/DLT serverless, reduzindo a execução de cerca de 30 para 8 minutos.
Backend e IoT
Desenvolvimento e deploy de um serviço Flask/Pydantic para processar leituras RFID, aplicar regras de negócio e atualizar MongoDB e SQL Server, executando em Docker em uma VM.
Plataforma e IA aplicada
Desenvolvimento de ferramentas Python para versionar e promover metadados do Genie. Redução de 75% no custo de saída de LLM em um pipeline de catalogação e implementação de modelos principal e fallback.
Tramontina Multi S.A.
Aprendiz de Processos Industriais
Fundamentos práticos em Python, PySpark, Databricks e dados industriais.
Trabalho com notebooks, camadas Bronze/Silver, análise de dados e Git. Exploração de provas de conceito com Prophet e LSTM para séries temporais durante a transição para desenvolvimento.
Aprendizado com propósito.
Formação acadêmica, credenciais verificáveis e estudos complementares.
Formação acadêmica
Univates
Em andamento
Bacharelado em Engenharia de Software
Detalhes
Na Univates, conecto os estudos de Engenharia de Software com desenvolvimento backend, engenharia de dados e projetos em equipe.
O idioma do documento é independente do idioma do site.
Engenharia de dados · PortuguêsVisualizar currículo
Mateus Carniel Brambilla
Engenheiro de Dados | Databricks | IA Aplicada
Engenheiro de Dados com experiência de produção no ecossistema Databricks, atuando diariamente com PySpark, SQL, Delta Lake, Unity Catalog e Asset Bundles. Constrói e mantém pipelines batch, automações de plataforma e soluções de IA aplicada. Atuou em mais de 20 jobs Databricks, migrou um pipeline de cerca de 20 notebooks para Lakeflow Pipelines/DLT reduzindo o tempo de cerca de 30 para 8 minutos, e reduziu em 75% o custo de saída de LLM em pipeline de produção.